零基础 AI 科普 / 01–06 合订
AI 基础知识
本书从人工智能的基本概念讲起,依次介绍模型如何学习、聊天 AI 如何回答问题,以及怎样判断结果是否可靠。每节的示意图都与正文相对应。
目录
01 人工智能是什么2
人工智能能完成哪些任务,模型与应用有何区别。
02 AI怎样从数据中学习5
数据、标签和训练,以及怎样判断模型是否学得好。
03 聊天AI和大语言模型8
回答如何生成,提示词、上下文和检索分别做什么。
04 AI怎样处理图片声音和视频11
图像、语音和视频怎样被识别、转换或生成。
05 AI在生活和工作中的用途14
推荐、翻译、资料整理与实际执行的区别。
06 AI为什么会出错17
幻觉、过时信息、数据偏差和来源核实。
零基础 AI 科普 / 第 1 篇
人工智能是什么
人工智能,简称 AI,是让计算机完成识别、预测、生成等任务的一类技术。手机把你说的话转成文字,是在识别声音。地图估计还有多久到家,是在预测时间。写作工具根据你的要求写一封邮件,是在生成文字。
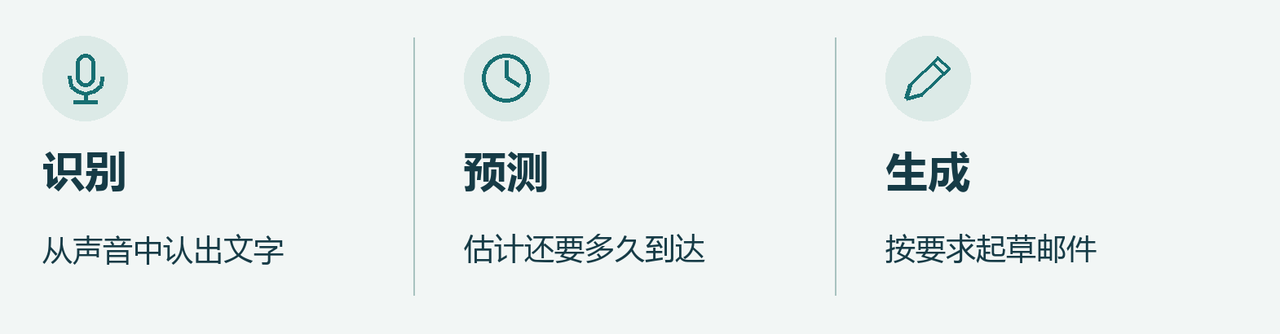
图 1.1 语音输入、预计到达时间和邮件初稿,分别对应三种不同任务。
为什么这些任务会用到 AI
计算器算“27 加 35”,按确定的加法规则就能得到答案。听清一句普通话却不一样。同一个“好”字,每个人的声音、语速和口音都不同,周围还可能有人说话。很难事先写出一套规则,列举所有可能的声音。
许多现代 AI 系统会从大量例子中学规律。语音识别系统可以接触许多录音以及相应文字,逐渐学会哪些声音变化常常对应哪些字词。这样,遇到以前没有听过的声音,也有机会识别正确。
聊天只是其中一种用途
有些 AI 能和人对话,有些只输出一个简单结果,比如“这封邮件可能是垃圾邮件”。有没有聊天框,和系统有没有用到 AI,是两回事。
零基础 AI 科普 / 第 1 篇
机器学习和深度学习是什么
这三个词说的范围不同。人工智能是一个研究领域,其中一类方法叫机器学习,而深度学习又属于机器学习。理解它们的关系,比记住三个定义更重要。
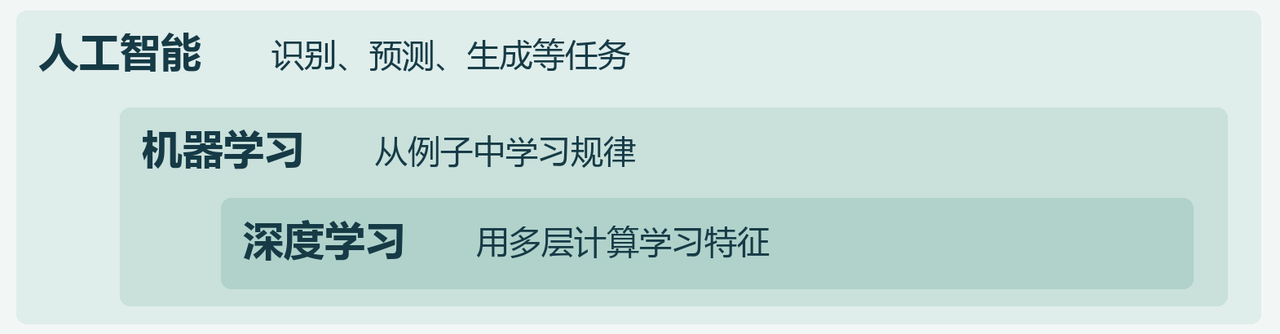
图 1.2 从外向内读。机器学习属于人工智能,深度学习又属于机器学习。
什么叫从数据中学习
以识别手写数字为例。人可以给计算机许多图片,并标出每张图写的是哪个数字。训练时,系统会反复比较自己的判断和已知答案,调整计算方式。最后得到的识别本领,可以用在没见过的手写数字上。这就是机器学习的一种做法。
深度学习的“深”是什么意思
这里的“深”指计算经过多层处理。识别图片时,有的计算对边缘和线条比较敏感,后面的计算能把这些线索组合成更复杂的形状。多层计算怎样组合,主要由训练决定。
零基础 AI 科普 / 第 1 篇
模型和应用有什么区别
模型是 AI 系统中负责某种计算的部分。经过训练的语音模型可以把声音转成文字,语言模型可以生成一段回答。应用则是人直接打开使用的软件。一个应用可能调用几个模型,也会用到搜索、文件存储等普通软件功能。
生成式 AI 是什么意思
“生成式”描述的是它能给出什么结果。输入一句要求,得到一封新写的邮件、一张图片或一段合成语音,这些都属于生成。输入一个词,在相册中找到过去拍过的照片,则属于检索。两种功能可以放在同一个应用里。
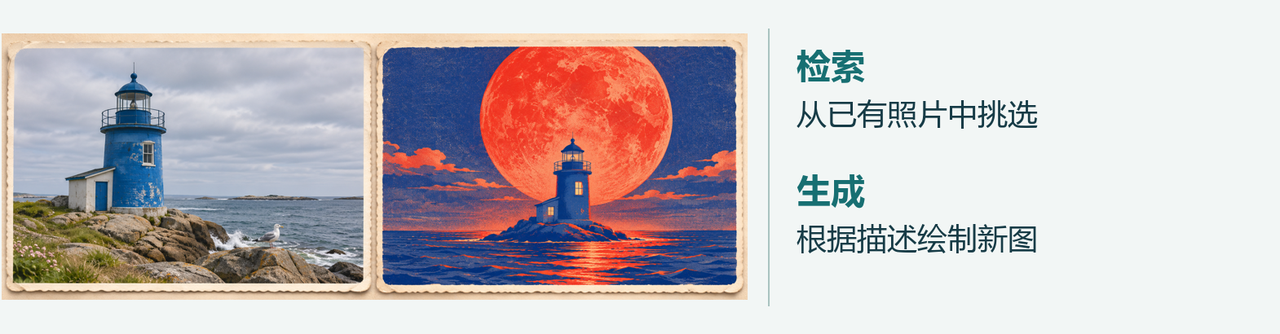
图 1.3 左图模拟检索已有照片,右图模拟按描述绘图。两幅灯塔图均为教学插画。
为什么一种本领不能代表所有本领
识字系统能准确读出一串车次编号,不代表它知道今天这班车是否晚点。前一个问题需要识别文字,后一个问题需要及时的列车运行信息。了解一个 AI 工具时,先看它具体负责什么任务,就容易理解它为什么在某些地方好用,在另一些地方会答错。
参考资料
IBM|什么是人工智能
Google|什么是机器学习
零基础 AI 科普 / 第 2 篇
AI 怎样从数据中学习
机器学习的基本做法,是用已有的例子调整模型,使它在遇到新情况时也能给出有用的判断。这里说的“学习”,指模型内部的数值发生了调整,进而改变了它的输出。
什么是数据和标签
假设要训练一个垃圾邮件识别系统。过去收到的邮件可以作为训练数据。“正常邮件”或“垃圾邮件”就是标签。标签告诉模型,这个例子已知的答案是什么。这种用带答案的例子进行训练的方式,叫监督学习。
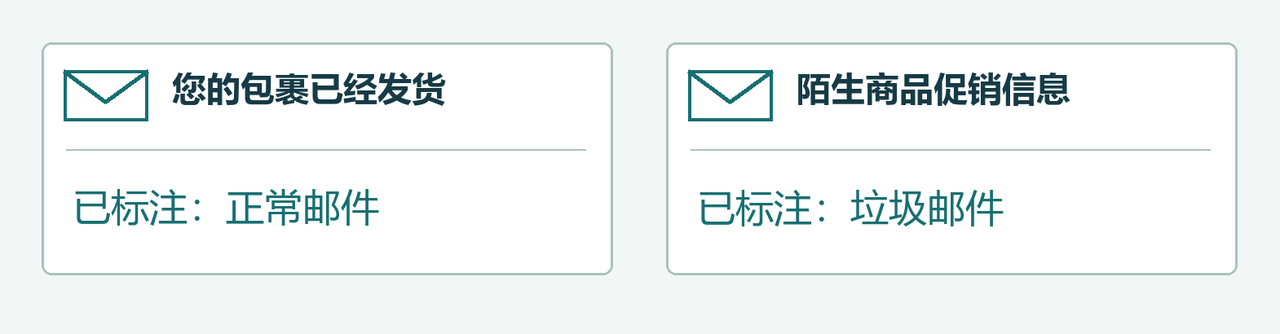
图 2.1 训练数据中的邮件和已知标签成对出现,标签说明这封邮件在训练时应归到哪一类。
模型在训练时调整什么
模型里有许多可以调整的数值,叫参数。刚开始,它的判断可能经常出错。训练程序会计算预测结果与标签之间的差距,再据此调整参数。经过许多次调整,模型可能学到哪些词和表达方式有助于识别垃圾邮件。
不必有人把每条规律写成规则。“优惠”两个字出现在广告里,也可能出现在一张正常的订单里。一个有用的模型通常需要结合整封邮件的其他线索来判断。
零基础 AI 科普 / 第 2 篇
训练好的模型怎样使用
训练是用一批例子调整模型。使用是把一条新的输入交给已经训练好的模型,取得这一次的结果。后一步常叫推理。例如,邮箱收到一封新邮件,系统给出“可能是垃圾邮件”的判断,这通常是一次推理。
为什么要用没见过的数据测试
如果用训练时见过的邮件检查模型,它可能只认得原来的文字和格式。更有意义的测试,是拿一批没有参与训练的邮件,看它能否继续分对。把学到的规律用到新例子上,这种能力叫泛化。
为什么“正确率很高”有时还不够
假设有 100 封测试邮件,其中 95 封正常、5 封是垃圾邮件。一个系统把全部邮件都判为正常,也能得到 95% 的正确率,却漏掉了所有垃圾邮件。因此还要分别看,它拦住了多少垃圾邮件,又错拦了多少正常邮件。这里的数字只是说明原理的例子。
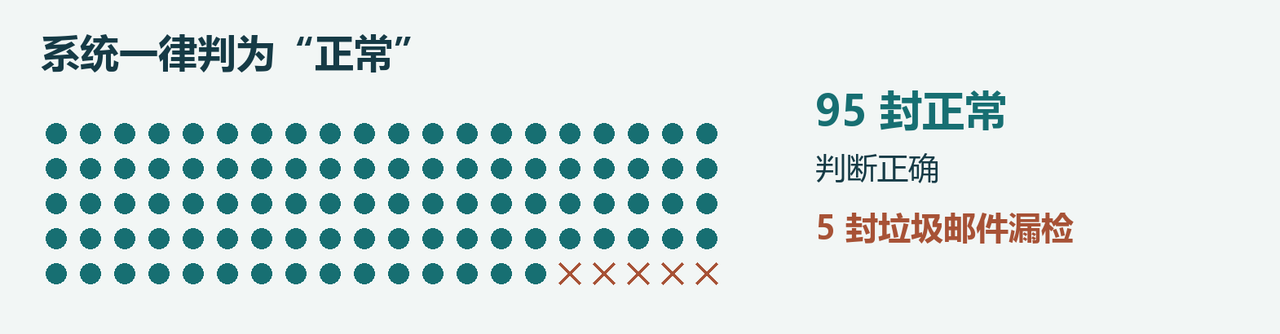
图 2.2 假设全部判为正常,100 封中答对 95 封,但 5 封垃圾邮件全都漏掉了。
零基础 AI 科普 / 第 2 篇
什么会影响学习效果
数据质量往往比数据条数更值得关心。假如训练录音都来自安静的房间,语音识别系统到了嘈杂的车站,表现可能下降。系统以前接触的声音与实际环境不同,原来的规律就未必够用。
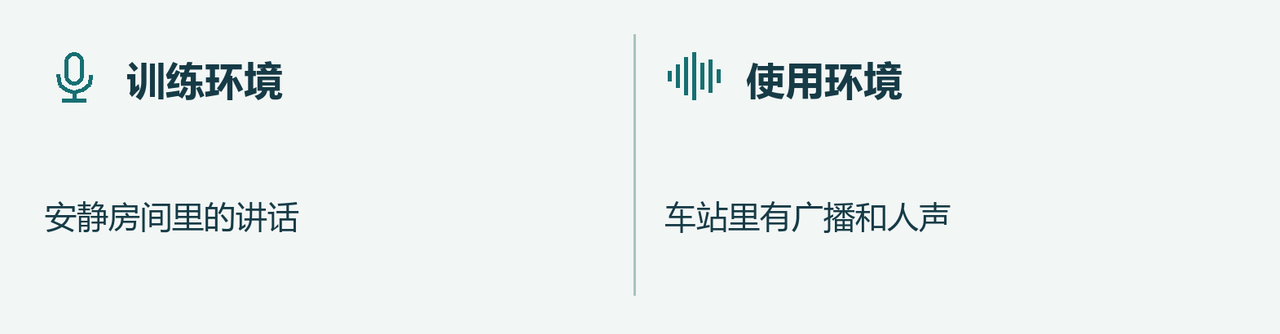
图 2.3 使用环境和训练样本差异较大时,原先有效的线索可能不够用。
错误标签会造成什么影响
如果许多正常的订单通知被误标成垃圾邮件,系统得到的训练信号就有问题。即便每次训练都照程序进行,它也可能把订单通知拦下来。标签写得是否准确、样本是否覆盖真实使用场景,都会影响最终效果。
所有训练都要人工标答案吗
不一定。语言模型的一种训练办法,是让模型根据上文预测接下来的一小段文字,再用原文中实际出现的内容检查预测。需要的答案就在原材料里,所以不用人工为每句话另写一个标签。这种做法属于自监督学习。
使用模型时,纠正它一句话,可能会改变接下来这段对话的回答。改变一次对话所参考的信息,与重新训练模型内部的参数,是两个不同的过程。
参考资料
Google|什么是机器学习
Google|训练数据的特点
Google|泛化与过拟合
零基础 AI 科普 / 第 3 篇
聊天 AI 和大语言模型
大语言模型是一类擅长处理和生成文字的 AI 模型。聊天应用可以用它来回答问题、改写文章、翻译或做摘要。“大”通常指模型里可调整的参数很多,训练时使用的文字也往往很多。
回答是怎样生成的
常见的语言模型先读取输入的文字,再估计接下来可能出现哪些内容,从中选出一小段。新生成的内容会成为下次生成的依据。这个过程反复进行,就能形成一句话、一段解释,甚至一篇文章。
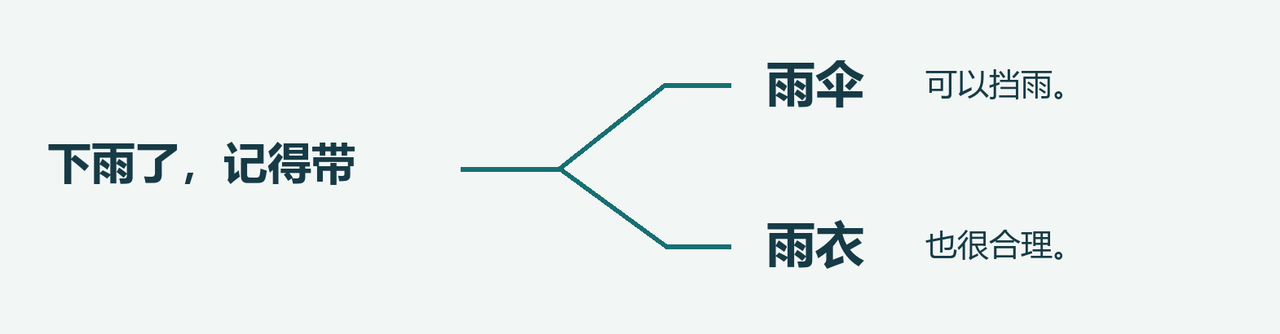
图 3.1 两条分支都是合理的续写。图中短语为阅读示意,并非模型实际的分词结果。
例如,上文是“这段话要写给第一次接触 AI 的人”,模型生成下文时,就可能采用更常见的词,先解释概念再举例子。如果要求换成“写给研究人员”,后面可能出现更多专业术语。
为什么同一个问题会有不同答案
一个问题往往有多种合适的表达。模型生成文字时,可以在几种可能的接法中作选择。两次回答措辞不同并不奇怪。但如果两次给出的日期、人数或出处不同,就需要用可查的资料来判断。
零基础 AI 科普 / 第 3 篇
提示词和上下文是什么
提示词是你交给 AI 的要求。“请把下面的通知缩短,保留时间和地点”,就是一句提示词。上下文则是模型这一次回答时能参考的信息,可以包括当前问题、前面的对话和随问题提供的材料。
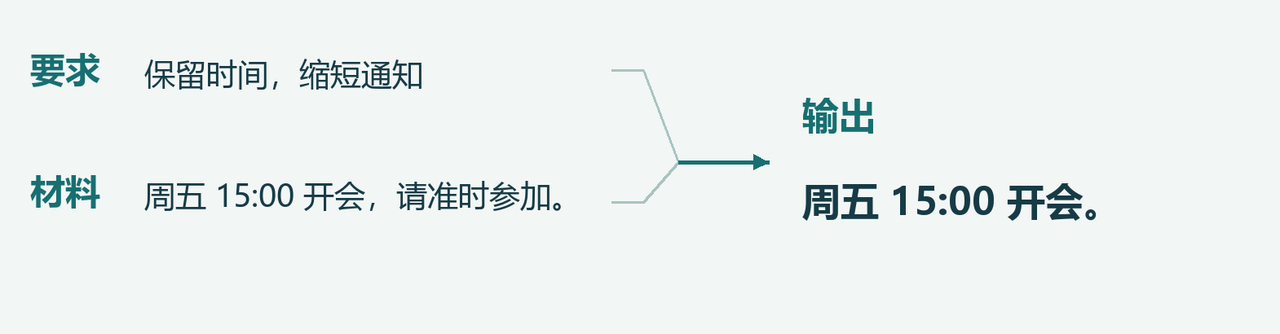
图 3.2 提示词说明要怎样处理,原文给出可以依据的事实。
模型为什么能接着上一句聊
前一句说“帮我概括这份通知”,后一句只说“再短一点”,只要上一段通知和回答仍在模型本次能参考的内容里,它通常就知道要缩短什么。可参考的内容有长度限制。对话很长,或换到新对话,早先的细节未必还能被看到。
为什么模型会按要求改写
许多聊天模型在完成基础的文字训练后,还会接受额外训练。训练者会提供指令和合适的答法,或者比较几个回答的质量,让模型更善于按照用户要求回复。这解释了为什么一句“保留原意,写得简短些”就能改变输出。
零基础 AI 科普 / 第 3 篇
生成回答和查询资料有什么区别
语言模型可以根据训练中学到的规律生成回答。训练材料里的信息有时间范围,模型也可能记错细节。因此,当它写出“今天仍然有效”时,这句话本身不能证明它刚刚查过最新资料。
联网查询多了哪一步
能联网的应用可以先搜索网页,再把找到的内容交给模型,由模型组织回答。它也可以只搜索指定的一批文件,例如某个单位提供的办事说明。先找相关材料、再依据材料回答的做法,常叫检索增强生成。
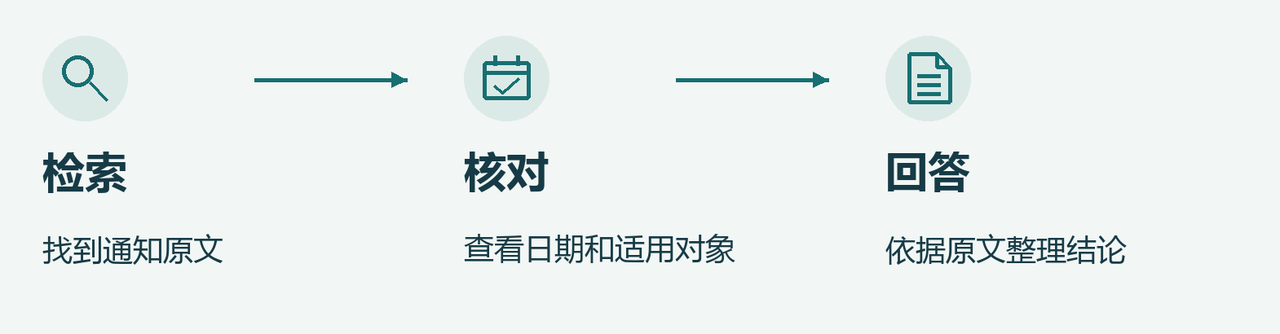
图 3.3 搜索提供材料,生成模型组织文字。材料过期,回答依然可能有误。
怎样理解回答里的出处
来源链接能帮助读者回到原文,但链接与结论要能对应。如果问题问的是今年的开放时间,而链接只写了去年的时间,就还不能据此确定今年的安排。引用的页面是否正确、适用日期是否一致,都比回答有多流畅更重要。
同一个聊天应用既可能直接生成文字,也可能调用搜索或计算工具。它在本次回答中实际用到了哪些材料和工具,会影响答案的可靠程度。
参考资料
Google|大语言模型入门
OpenAI|语言模型怎样学会遵循指令
Meta AI|检索增强生成
零基础 AI 科普 / 第 4 篇
AI 怎样处理图片声音和视频
图片、声音、文字和视频,是信息的不同形式,也叫不同的“模态”。AI 系统能联系两种或更多形式的信息时,就具有多模态能力。例如,看一张照片并用文字回答问题,需要把视觉信息和文字联系起来。
图片里有什么可以计算
数码图片由许多像素组成。每个像素都有表示颜色的数值,许多像素排列在一起,形成边缘、形状和纹理。经过训练,图像模型可以利用这些线索,判断照片里可能有哪些物体,或者指出物体大致位于哪里。
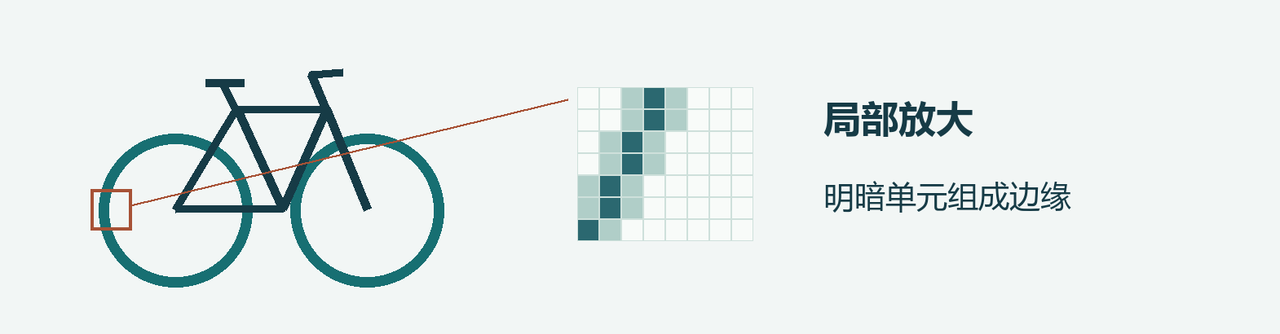
图 4.1 放大的车轮边缘由许多像素组成。物体轮廓来自一片区域内的明暗排列。
怎样把图片和文字联系起来
一种做法是让模型接触许多图片和相应的文字说明,学习哪些图像特征与哪些表述经常相配。例如,照片中有一辆停在路边的自行车,“一辆自行车”通常比“一艘轮船”更匹配。这样学到的联系,也可以用来按文字寻找图片。
如果物体太小、被遮挡,或问题涉及照片看不到的内容,模型的判断就可能不可靠。
零基础 AI 科普 / 第 4 篇
听写和朗读有什么区别
听写和朗读处理的是相反方向的任务。听写把一段人声变成文字,常用于字幕和语音输入。朗读把已有文字变成声音,常用于有声阅读或播报通知。两种功能经常出现在同一款应用中。
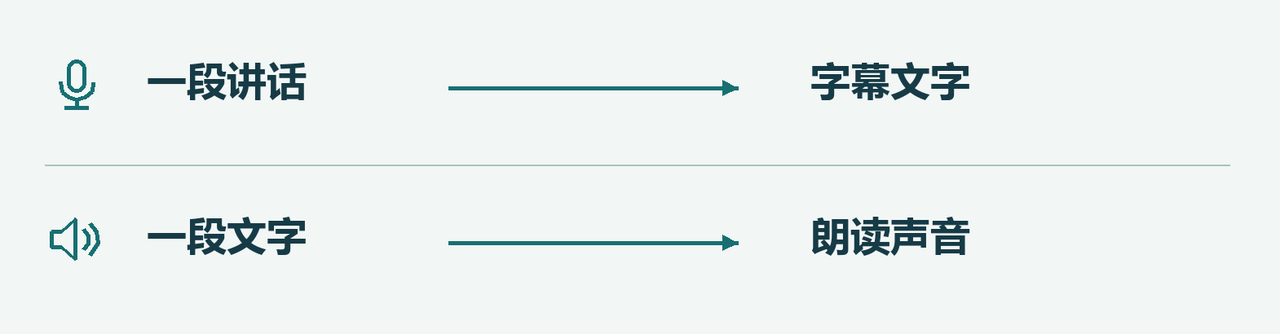
图 4.2 听写的输入是声音,朗读的输入是文字,两者的处理方向相反。
录音怎样变成文字
录音设备按时间记录声音信号的变化。识别模型可以分析不同时间段里声音的强弱和频率特征,并利用前后文,判断说话者可能说了哪些词。口音、背景音乐、多人同时讲话,都可能增加识别难度。
字幕为什么会差一个字
“会议延期”和“会议不延期”只差一个“不”字,意思却相反。如果那一刻刚好有杂音,系统可能漏掉这个字。字幕排得整齐,只代表输出格式清楚。涉及决定、金额或日期时,仍要看它是否和录音一致。
零基础 AI 科普 / 第 4 篇
生成图片和生成视频
根据一句描述绘制一幅新图,叫图像生成。它和从相册里寻找旧照片不同。寻找照片要匹配已有内容,生成图片则会产生新的像素,所以两次输入同样的描述,也可能得到不同构图。
一种常见的绘图方法
有些生成模型使用扩散方法。生成过程从一片随机噪声开始,在文字描述的引导下,多次调整画面,让物体轮廓、颜色和细节逐渐形成。文字说了“红色雨伞”,却未必规定了伞柄样式、光线方向和拍摄角度,这些细节可能由模型补出来。
视频为什么更复杂
视频是按时间排列的一系列画面。生成视频时,同一个人或物体在前后画面中要保持一致,动作也要连贯。例如,一个人把杯子放到桌上,杯子不能在下一帧突然换颜色或换位置。因此,一段视频可能每一帧看起来都清楚,连起来看却有不合常理的变化。
生成结果可以用于表达想法或制作示意图。要证明某件事真实发生过,还需要能够说明来源的记录。
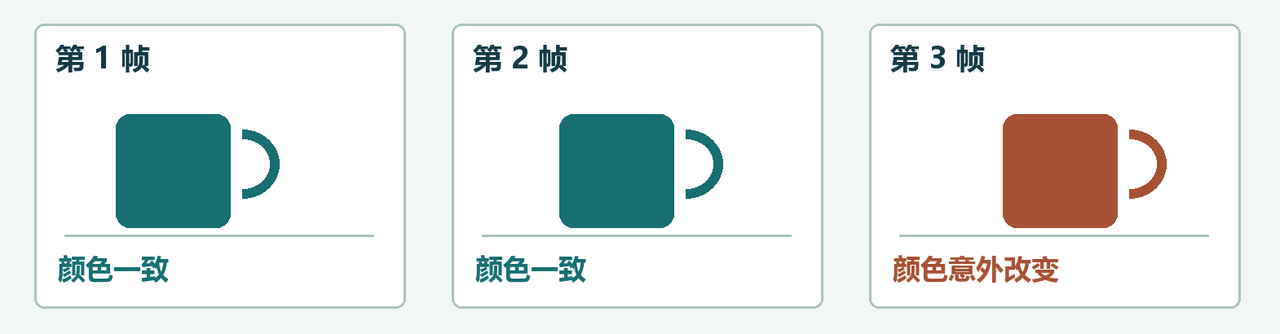
图 4.3 示意分镜中第三帧的杯子变色了。逐帧看很清楚,连起来却不连贯。
参考资料
OpenAI|CLIP 与图文匹配
Whisper 研究论文|语音识别
Google Research|Imagen 图像生成研究
零基础 AI 科普 / 第 5 篇
AI 在生活和工作中的用途
日常应用中的 AI 经常用来估计结果或筛选信息。地图估计还要多久到达,音乐软件推荐下一首歌,邮箱判断哪些邮件可能是垃圾邮件。这些功能各自解决一种具体问题。
地图怎样估算到达时间
地图先要知道道路怎样连接,才能规划路线。要估计用时,还可以结合路段长度、以往的通行速度和当前路况。若途中开始拥堵,预计到达时间就可能延后。时间变化,是因为新信息改变了估计。
推荐内容为什么因人而异
推荐系统可以参考内容本身的相似之处,也可以利用许多人的观看或收听记录。常见做法是先挑出一批可能相关的内容,再给它们打分、排序,并适当调整展示顺序。
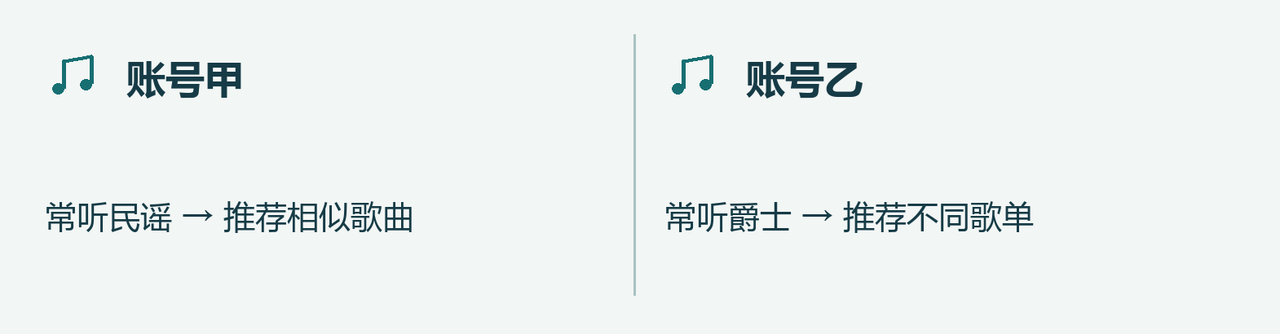
图 5.1 同一款音乐应用可以依据两个账号的收听记录,给出不同的排序。
一次点击不一定代表喜欢。一家人共用账号时,系统可能把几个人的兴趣混在一起。因此,排在前面的内容只能表示系统认为它可能适合这个账号,不能说明所有人都会喜欢。
零基础 AI 科普 / 第 5 篇
写作翻译和资料整理
在文字类工作中,AI 可以改写已有内容、从长文里提取要点,也可以根据要求生成初稿。这些任务都需要知道原材料和写作目的。两者越明确,越容易判断结果是否合适。
会议纪要要保留哪些区别
原话是“如果样品周四到了,我们就周五开会”。摘要写成“周五开会”,虽然更短,却删掉了开会的条件。整理纪要时,时间、负责人、前提,以及某件事是建议还是决定,都应当和原文一致。
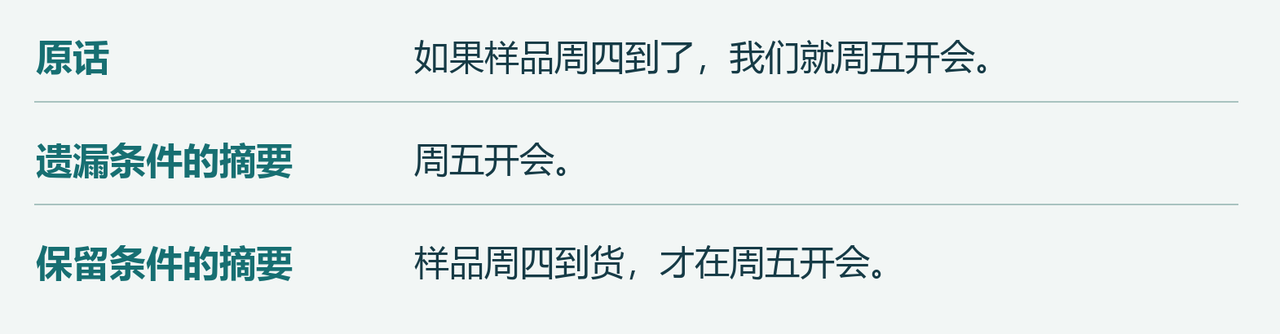
图 5.2 摘要必须保留开会的前提,否则会把尚未确定的计划写成决定。
翻译为什么需要看前后文
英文单词 bank 可以指银行,也可以指河岸。附近有“存钱”,通常指银行。附近有“沿河散步”,则更可能指河岸。机器翻译也要借助前后文决定词义。只有一个孤立的词时,可用线索较少。
哪些结果比较容易核对
把一页已知材料压缩成摘要,可以逐条对照原文。如果要求 AI 独立补充材料中没有的数字、人物或原因,那部分内容就需要额外来源支持。
零基础 AI 科普 / 第 5 篇
提出建议和实际执行有什么区别
聊天助手可以拟一封邮件,也可以在支持相关功能的应用中调用工具。工具是模型可以使用的外部功能,例如搜索文件、读取日历或创建日程。能给出建议,并不代表应用已经执行了这件事。
什么是智能体
在 AI 应用中,能围绕一个目标选择下一步操作、调用工具并根据返回结果继续处理的系统,常称为智能体,也叫 Agent。例如,要安排会议,它可能先查几个人的空闲时间,再选择合适的时段。
执行结果由什么决定
如果应用只被允许查看日历,就只能提出时间建议。如果它具有创建日程的权限,也要等日历服务成功保存记录,会议才真正建好。判断一项工作是否完成,应以相关系统实际产生的结果为准。
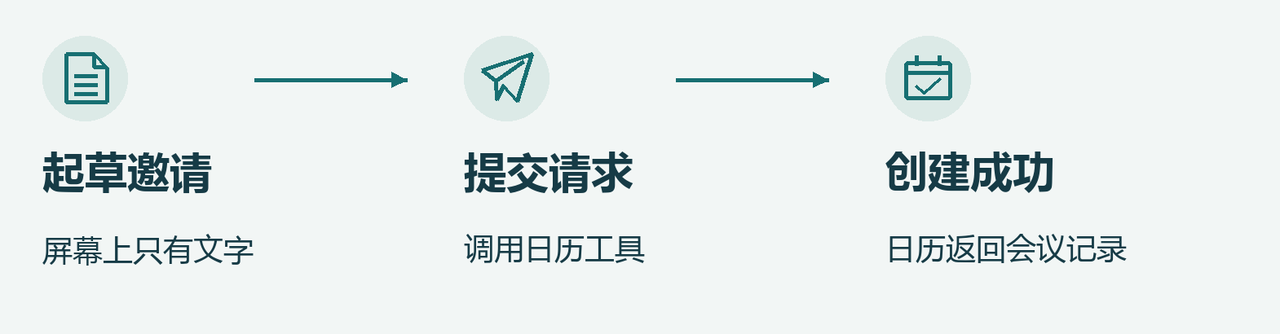
图 5.3 只有日历成功保存记录,创建会议的操作才算完成。
同样的区别也适用于写文件、订座和发送邮件。屏幕上出现一段草稿,与文件已经保存、订单已经建立或收件人已经收到邮件,分别对应不同的状态。
参考资料
Google|推荐系统怎样筛选和排序
Google|推荐系统怎样找到候选内容
Anthropic|工具调用与智能体
零基础 AI 科普 / 第 6 篇
AI 为什么会出错
AI 的答案可能有错,即使它说得很流畅、用了专业词,还列出了出处。语言模型擅长生成符合上下文的文字,但生成一句话时,并不会自动为这句话找到证据。
什么是 AI 幻觉
生成式 AI 有时会给出听起来合理、实际错误或缺少依据的细节,常见的例子有编造书名、引用不存在的研究,或说某篇文章表达了它没有表达过的结论。这类现象常被称为“幻觉”。
过时信息是另一类错误
一份旧通知确实写过“周日开放”,今天却可能临时闭馆。即便 AI 准确复述了旧通知,也没有回答好“今天是否开放”。涉及现状的问题,需要信息与具体日期、地点和对象对应。
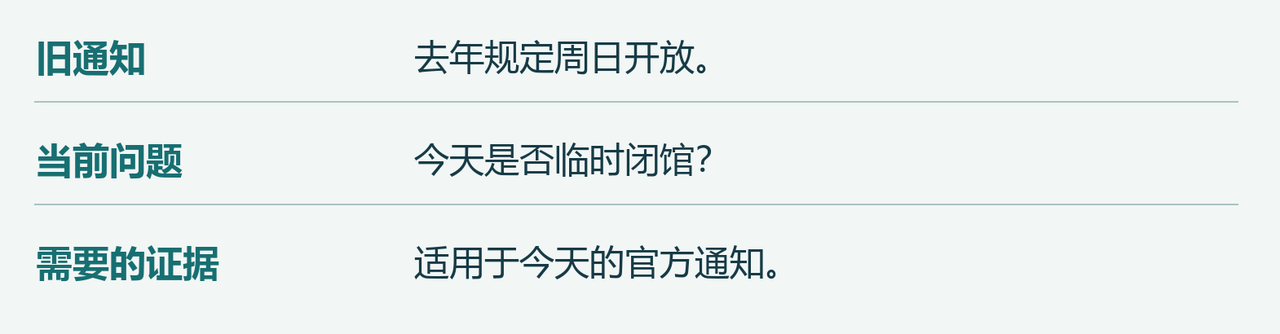
图 6.1 旧通知即使当时正确,也未必能回答今天的问题。
为什么再问一次还不够
第二次回答可能得到同样的说法,因为模型用了相近的规律或同一条错误材料。重复回答可以帮助发现矛盾,却不能替代来自原始通知、原始数据或直接记录的证据。
零基础 AI 科普 / 第 6 篇
偏差和信息不足怎样影响判断
模型接触过哪些例子,会影响它在哪些情况下表现较好。假如训练录音里几乎都是安静环境中的标准发音,模型识别某些地区口音或嘈杂环境中的讲话时,就可能更常出错。如果某类人或情形持续得到较差结果,就值得检查训练数据和系统设计是否存在偏差。
缺失的信息不能靠语气补足
模糊的照片里,一个人手上似乎拿着药盒。但如果包装文字看不清,就无法仅凭照片确定具体名称。模型可以描述看得到的部分,也可能对看不清的部分作出猜测。回答写得具体,不会让原图增加信息。
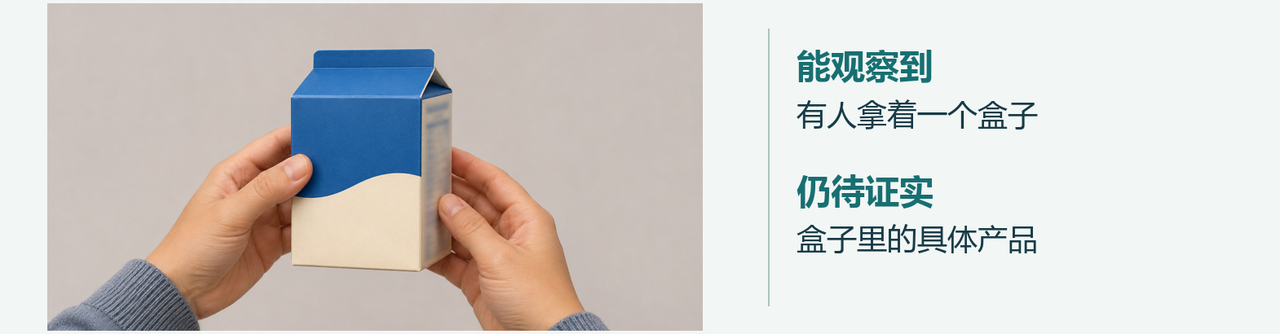
图 6.2 图中能看出有人拿着盒子,细字不足以确认品名。这是 AI 生成的观察示意图。
为什么带链接也要看原文
链接可能真实存在,却指向不同年份、不同地点或不同条件下的资料。判断答案时,关键是链接中的具体内容能否支持相应结论。
零基础 AI 科普 / 第 6 篇
生成内容和个人信息
图片、音频和视频都能由 AI 生成。一段听起来像熟人的声音,或一张看起来像新闻照片的图,单凭逼真程度不足以确认身份或证明事件发生。发布者、原始文件和其他独立记录可以帮助判断来历。
内容来源能说明什么
有些文件附带数字记录,说明哪些人或工具签署了来源信息、文件经历过哪些编辑。这类记录有助于了解文件的历史,但不能单凭签名证明配文中的所有说法。文件没有这类记录,也不能直接认定为伪造。
把材料交给在线 AI 意味着什么
请在线服务总结一份材料时,发送的文字或文件会交给服务处理。如果原件含有电话、住址、证件号码或内部信息,这些内容也会一并传入。是否保存、谁能访问、是否用于改进服务,要看具体产品、账号和设置。
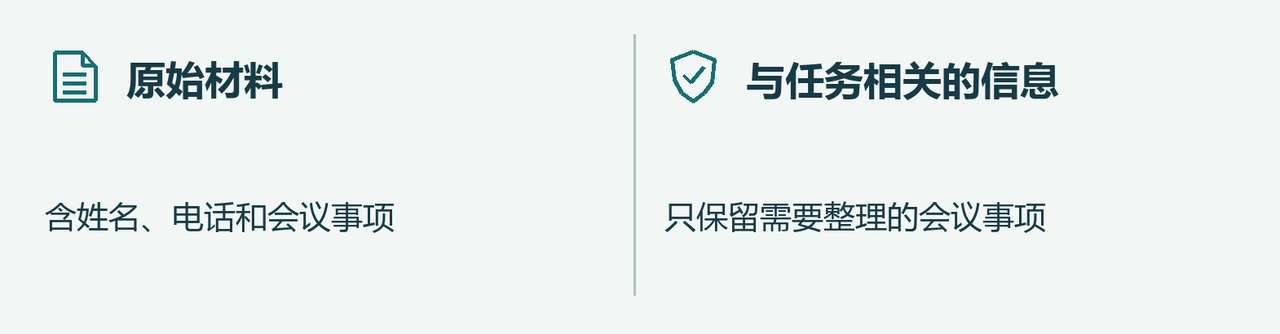
图 6.3 在线服务会收到实际提交的内容。示例中,整理会议事项并不需要电话号码。
对重要结论,先分清哪些来自给定材料、哪些是推测、哪些已由独立来源证实,比单看语气更可靠。
参考资料
美国国家标准与技术研究院|生成式 AI 风险概况
Google|模型在新数据上的表现
C2PA|数字内容来源记录常见问题