零基础 AI 科普 / 第 9 篇 · 资料核对至 2026 年 11 月 4 日
目前主流 AI 能做什么
今天常见的 AI 产品可以处理文字、图片、声音和数据,有的还能调用搜索、计算或办公工具。这里按任务介绍常见能力。一个产品是否具备某项能力,要看它实际接入的模型、工具和资料。
阅读、写作和翻译
给出一份通知,AI 可以提取截止日期、参加条件和提交材料,或改写成较容易阅读的版本。它也可以翻译文本、调整语气。需要核对的是原意是否保留,尤其是金额、专有名词和“仅限”“暂定”等条件。
资料搜索和综合
支持联网搜索的产品可以寻找相关网页,再将多份资料整理成答案,并列出出处。找出三条网页和得到三个独立证据并不相同:几篇文章可能都转述同一份公告。判断结论时,应查看来源日期、原始发布者和原文内容。
表格分析和计算
具备数据分析工具的应用可以读取表格、运行计算并画图。比如按月份汇总订单时,业务上可能需要扣除退款,也可能要按发货日期统计。模型可以完成计算,但统计口径需要先说清楚。
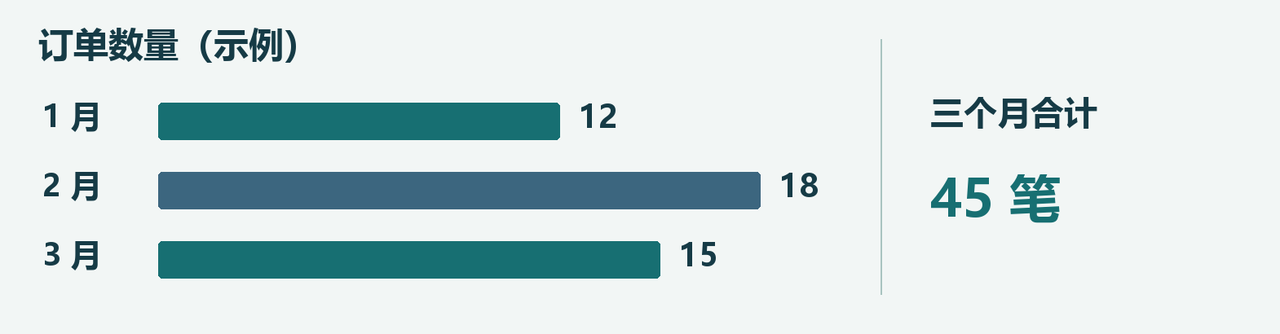
图 9.1 示例数据:三个月分别有 12、18、15 笔订单,共 45 笔。若要统计销售额,还需要金额字段。
本页资料
OpenAI|ChatGPT 功能说明
OpenAI|表格与数据分析
零基础 AI 科普 / 第 9 篇 · 资料核对至 2026 年 11 月 4 日
图片语音和视频能力
看图和生成图片
看图是根据已有图像回答问题。比如给一张柱状图,AI 可以描述哪一项更高,但字太小、坐标轴被裁掉时可能读错。生成图片则是根据文字或参考图创作新画面,可用于草图、海报构思和示意图。生成的细节不一定符合实物。
听写、朗读和语音对话
语音识别可以把讲话转成字幕,语音合成可以把文字读出来。支持实时语音的产品还能接收口头提问、用声音回答。背景噪声、多人同时说话和读音相近的姓名,都可能造成识别错误。
生成视频片段
部分视频模型支持用文字描述或一张参考图生成短片。设计人员可以先看动作、镜头和色调,再决定是否实拍。生成片段仍可能出现物体突然变形、口型不准或前后动作衔接不自然等问题。
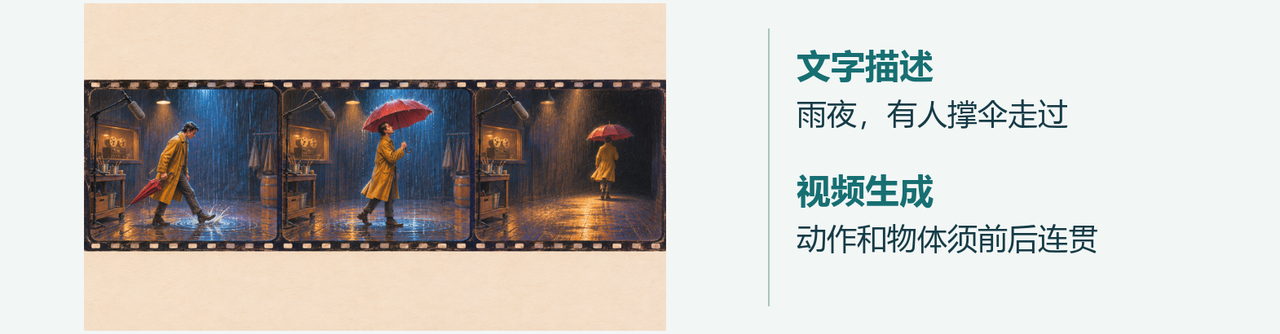
图 9.2 文字描述“雨中撑伞”可以对应多个连续画面。图为静态分镜示意,不是实拍记录。
本页资料
Google|Gemini 应用功能
字节跳动|实时语音模型
Google DeepMind|Veo 视频生成
零基础 AI 科普 / 第 9 篇 · 资料核对至 2026 年 11 月 4 日
编程、预测和工具调用
多步分析和编程
部分模型可以结合几个条件分析问题,比如同时考虑交货期限、可用工时和库存,提出排产顺序。是否满足全部约束,还要逐项验算。编程助手也能解释代码、起草修改和测试。修复日期排序错误后,应实际运行程序,检查旧数据和不同日期格式。
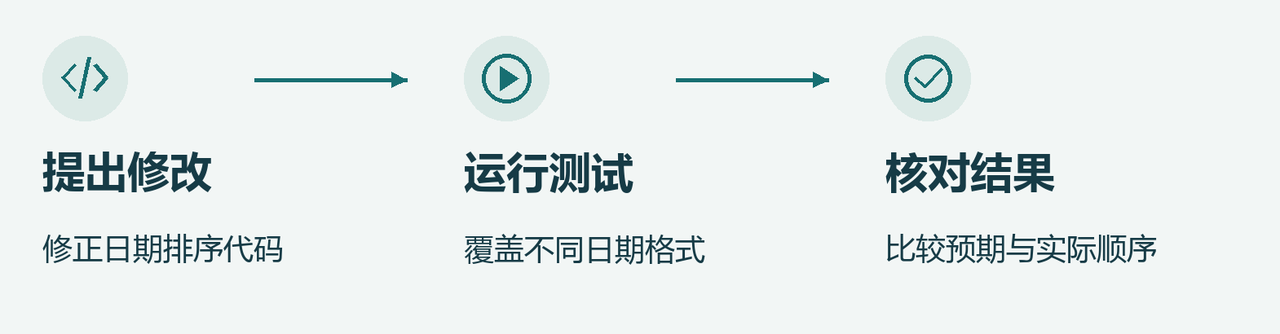
图 9.3 给出一段代码只是开始。它是否有用,需要通过运行和检验来判断。
预测和发现异常
预测模型可以利用过去的数据估计将来的需求或到达时间。异常检测则在已有数据中寻找与常见情况不同的记录。两者输出的是需要考虑的可能性。销量异常升高,可能是促销、漏记退货或真正的需求变化,还要结合业务信息判断原因。
调用工具完成多个步骤
有些 AI 系统能根据目标选择工具,并根据执行结果继续工作。例如,先读取允许访问的文件,再汇总数据并生成图表。每一步都有不同的完成条件:收到了文件、计算已运行、图表已保存。工具权限、返回结果和人工确认,共同决定任务最终是否完成。
本页资料
GitHub|代码审查功能
Google Cloud|零售预测应用
Anthropic|工作流与智能体
DeepSeek|推理模式说明